이게 되나? 싶었는데 이게 되네요.
3090 24G 단일 카드로는 어렵지 않을까 싶었는데... 심지어 llama 로 Qwen3.8-27B 사용할 때보다 퍼포먼스도 더 좋고 결과물은 더 좋습니다. 안 쓸 이유가 없네요.
참고로 제 시스템은 Ryzen 5600x / B450 / DDR4 80GB / RTX 3090 24GB 입니다.
다음은 사용한 설정들 내용입니다.
- 유닛 주요 설정:
- GPU 0번 사용 (CUDA_VISIBLE_DEVICES=0), PATH에 CUDA 12.8 포함
- Restart=on-failure (15초 후 재시작, 10분 안에 최대 3번)
- 시작 대기 600초, 종료 대기 90초
- LimitMEMLOCK=infinity, OOMScoreAdjust=-200
- comfyui, yue-studio와 동시에 실행되지 않음 (Conflicts)
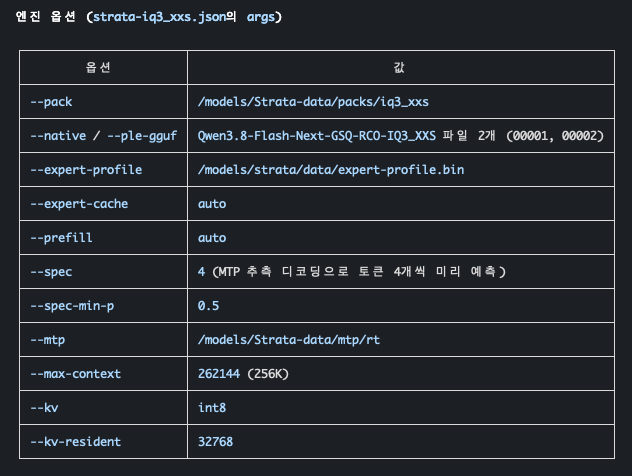
서버 설정 (같은 JSON 파일)
- model_name: qwen3.8-flash-next-iq3_xxs (다른 모델 이름으로 요청해도 받아들임)
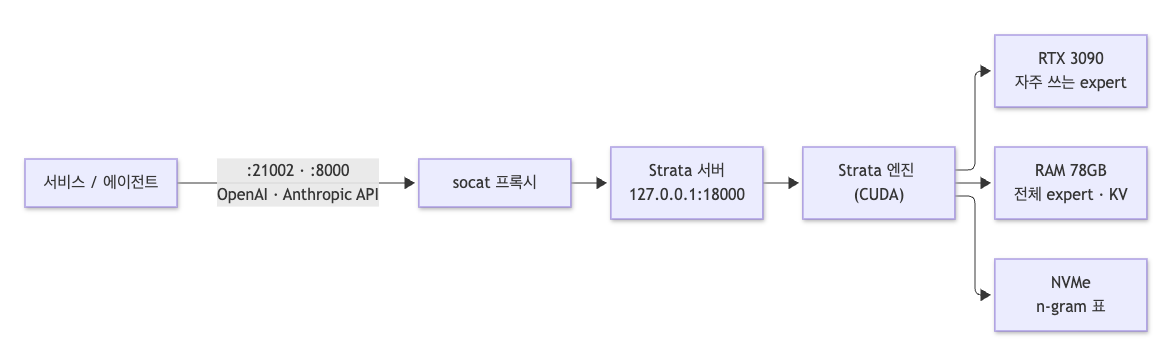
- host:port: 127.0.0.1:18000. llama-proxy-ext가 이 포트를 외부의 0.0.0.0:8000과 :21002로 중계합니다.
- api_key: 설정돼 있음 (위에서는 가림)
- fit_max_tokens: true. 요청한 max_tokens가 남은 컨텍스트를 넘으면 자동으로 줄여줍니다.
- tokenizer: 팩 안의 tokenizer를 씀
- 로그 파일: /models/strata/strata-iq3_xxs.log (systemd journal에도 남음)
현재 자원 사용량
- VRAM: 23.8 / 24.6 GB 사용 (거의 다 찬 상태)
- 엔진 메모리(RSS): 약 45.7 GiB
한눈에 보기
요약
| llama.cpp 27B (이전) | Strata IQ3_XXS (현재) |
|---|
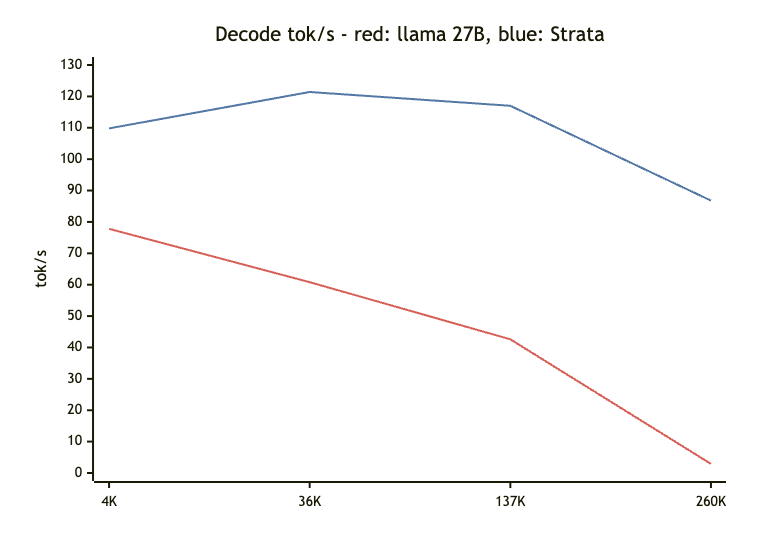
답변 생성 4K / 36K / 137K / 260K | 78 / 61 / 43 / 2.9 tok/s | 110 / 121 / 117 / 87 tok/s |
프롬프트 처리 4K / 36K / 137K / 260K | 1,008 / 1,081 / 769 / 546 tok/s | 1,595 / 2,226 / 2,277 / 2,106 tok/s |
260K 첫 토큰까지 | 476 s | 123 s |
코딩 6문제 / 에이전트 2과제 / 236K needle | 4/6, 2/2, 통과 | 6/6, 2/2, 통과 |
VRAM / RAM | ~22 GB / ~20 GB(+드라이버) | ~23.5 GB / ~40 GB |
→ Strata 로 교체, llama.cpp · vLLM 삭제.

