Galaxy Z Fold 7 (SM-F966N) 실측 결과
- 칩: Snapdragon 8 Elite (SM8750, Hexagon v79 NPU, Adreno 830), Android 17, 12GB RAM
- 빌드: S23U와 동일 llama.cpp b11976 (OpenCL+HTP)
Qwen3-4B HTP 프리필
• Fold7 (8 Elite): 1,134 t/s
• S23U (8 Gen2): 383 t/s
• 배율: 3.0x
Qwen3-4B HTP 디코딩
• Fold7 (8 Elite): 19.6 t/s
• S23U (8 Gen2): 8.6 t/s
• 배율: 2.3x
Qwen3-4B OpenCL 디코딩
• Fold7 (8 Elite): 11.7 t/s
• S23U (8 Gen2): 1.4 t/s
• 배율: 8x
LFM3-1.7B HTP
• Fold7 (8 Elite): pp 2,670 / tg 40.8
• S23U (8 Gen2): pp 1,204 / tg 23.0
• 배율: 1.8x
llama-server 실측 체감 (Qwen3-4B HTP): TTFT 0.14~0.19초, 스트리밍 15.3~17.6 tok/s — 실시간 대화 충분합니다.
① 한국어 교정 품질 정량 비교 — Fold7 HTP, 동일 프롬프트 10문항
'보여집니다→보입니다' 교정
• Qwen3-4B: ✅ 정확
• LFM3-1.7B: ❌ 재해석 뒤엉킴
'김치찌개 였어요/맛있었 습니다' 띄어쓰기
• Qwen3-4B: 부분 (첫 단락만)
• LFM3-1.7B: ❌ '김치찌개였나요?'로 의미 변조
'업로드 하기→업로드하기'
• Qwen3-4B: ✅
• LFM3-1.7B: ❌ 설명만 장황
'감동적이였던→감동적이었던'
• Qwen3-4B: '감동스러운'으로 대체(허용권)
• LFM3-1.7B: ✅ 의미 그대로 축약
물음표 중복·이중존댓말 정리
• Qwen3-4B: ✅ 2문항 모두 깔끔
• LFM3-1.7B: 장황하지만 최종 수정본은 맞음
'그거 그거' 구어 정리
• Qwen3-4B: ✅ 명문장으로
• LFM3-1.7B: ❌ "도움드릴 수 없고" 거부 응답
게시판 한 줄 요약
• Qwen3-4B: ✅ 3문장 정제
• LFM3-1.7B: 원문 복사에 가깝고 오타('어대') 발생
**요약 점수**
• Qwen3-4B: 8.5/10
• LFM3-1.7B: 2.5/10
평균 응답시간
• Qwen3-4B: 1.2초
• LFM3-1.7B: 3.1초
판정: 교정·요약 단계는 Qwen3-4B 압승. LFM3-1.7B는 HTP로 40 tps나 되지만 한국어 교정 지시.follow 능력이 프로젝트 요건(품질 우선)에 못 미칩니다. LFM3는 "속도·에이전트성 특화"라 교정용이 아니고, 1.7B는 메인에서 제외 권고. 최종 아키텍처는 Qwen3-4B HTP 단일 + (향후) 상위 4B급 교체가 맞습니다.
② STT/TTS 검증 (Fold7)
- 기본 STT provider: 구글 온디바이스(AiAi, as.oss 993 버전 설치 확인) — SpeechRecognizer로 외부 앱 호출 가능 경로 S23U와 동일
- 삼성 Bixby on-device 한국어 패키지(bixby.ondevice.kokr) + 삼성 한국어 TTS 음성팩(SMT.lang_ko_kr_r00) 실재 — TTS는 삼성/구글 둘 다 가능
- 오프라인 인식 품질 자체는 앱에서 실시간 마이크 테스트가 필요해서, 이는 데모 앱 단계에서 확인하는 게 정확합니다 (비행기모드 켜고 발화 테스트 10분이면 판정)
최종 제안 아키텍처 (검증 기반)
- 추론: llama.cpp 서버 내장(AAR) + Qwen3-4B Q4 HTP — TTFT 0.19s, 15~19 tps, 프리필 1,134 tps로 3계층 기억 설계의 "매번 재투입"도 여유
- 교정·초안: 동일 모델 (시스템 프롬프트 분기)
- STT: SpeechRecognizer(구글 온디바이스) 우선 + 삼성 음성 입력 폴백 / TTS: Google TTS ko, 삼성 TTS 폴백
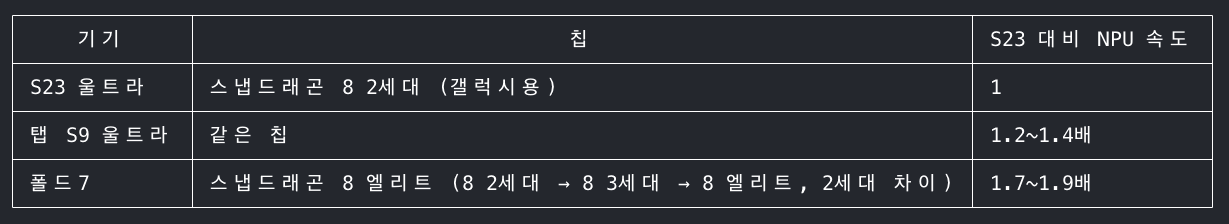
지금 집에서 굴리는 폰들 npu를 체크해 봤슴미다
제미나이 라이브 처럼 실시간 대화를 stt + tts 로 가능한지를 gpt에게 물어보니 가능은 한데 느리고 텀이 길 다고 함미다
s23u정도는 그냥 돌아간다 정도고 폴드7이나 s26u 정도 되야 참고 쓸만하다 정도 나올거 같슴미다
S23 Ultra — LFM3-1.7B vs Qwen3-4B 실측 비교 (llama.cpp b11976 Snapdragon 빌드)
HTP(NPU) 프리필 pp512
• LFM3-1.7B Q4_K_M: 1,203.8 t/s
• Qwen3-4B Q4_K_M: 383.5 t/s
HTP(NPU) 디코딩
• LFM3-1.7B Q4_K_M: 23.0 t/s
• Qwen3-4B Q4_K_M: 8.6 t/s
OpenCL(GPU) 디코딩
• LFM3-1.7B Q4_K_M: 13.1 t/s
• Qwen3-4B Q4_K_M: 1.4 t/s (이 빌드에서 Qwen3 OpenCL 취약)
CPU 디코딩
• LFM3-1.7B Q4_K_M: 14.7 t/s
• Qwen3-4B Q4_K_M: 600초 타임아웃 (사실상 사용 불가)
서버 실측 TTFT (HTP/GPU)
• LFM3-1.7B Q4_K_M: 1.39 s
• Qwen3-4B Q4_K_M: 0.26 s
서버 실측 스트리밍 tps
• LFM3-1.7B Q4_K_M: 13.4 t/s
• Qwen3-4B Q4_K_M: 9.0 t/s
메모리(가중치)
• LFM3-1.7B Q4_K_M: 1.0 GB
• Qwen3-4B Q4_K_M: 2.3 GB
한국어 품질 (글쓰기 작업 테스트)
- Qwen3-4B (HTP): 간결하고 자연스러운 게시판 초안, system 프롬프트 경어체 유지 잘 됨. 다만 메모를 과도하게 압축해 원문 의도 일부 축소개재
- LFM3-1.7B (HTP): 구조화(제목/섹터/핵심 메시지) 강력, 메모 내용 충실하게 반영. 단 장황하고 반말 혼입 occasionally, "접근성" 같은 단어를 다시 쓰는 재해석 경향
요번에 새로 나온 LFM3-1.7b 모델이 온디바이스용으로 나왔다고 해서 사용해 봤슴미다
속도는 괜찮은데 문제는 한글 임미다
한글 데이터가 부족해서 모델 제작 업체들이 영어나 중국어 만큼 잘 아웃풋으로 내는게 힘든가 봄미다