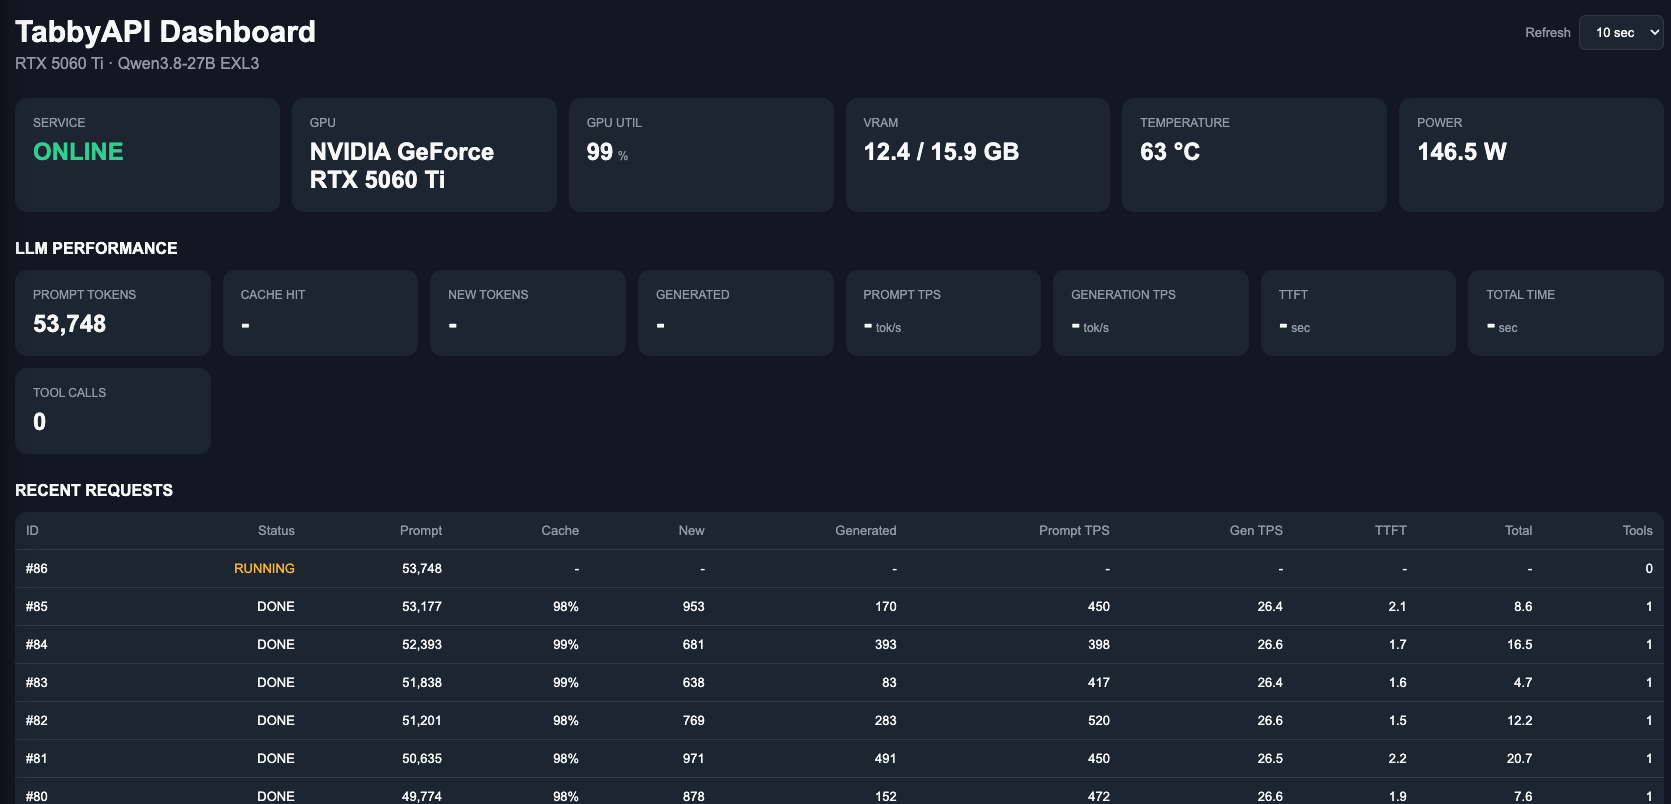
5060 Ti 16GB와 M1 Max 32GB에서 Ollama로 Qwen3.x 계열을 이것저것 테스트하면서 놀아보고 있는데, 단순히 몇 번 돌려보는 테스트에서는 "생각보다 잘 되는데?"라는 느낌이었습니다.
그런데 실제로 업무처럼 긴 작업을 넣고 계속 사용해보니 이야기가 달라지더군요.
몇 번은 정상적으로 끝나는 것 같다가도 실제 사용 환경처럼 작업량이 조금만 늘어나면 실패가 발생하고, 작업이 완료됐다고 나오더라도 정말 제대로 완료된 게 맞나 싶은 경우가 있었습니다. 중간에 먹통이 돼서 결국 취소하고 다시 실행하는 것도 반복됐고요.
결국 제 결론은 "테스트용으로는 재미있지만, 아직 실사용은 어렵겠다"였습니다.
그러다 ExLlama로 RTX 5060 Ti에서 Qwen3 27B EXL3를 돌려봤는데, 느낌이 꽤 달랐습니다.
일단 가장 크게 느껴진 건 꾸준히 실행된다는 것입니다. 한두 번 잘 되는 게 아니라 비슷한 작업을 반복해서 돌려도 계속 실행이 되니, 처음으로 "이 정도면 실제로 써볼 만하겠는데?"라는 생각이 들었습니다.
특히 저처럼 단순 채팅보다는 코드 분석이나 수정, 여러 단계의 작업을 연속으로 시키는 경우에는 이 차이가 꽤 크게 느껴지네요.
확실히 현재 기준으로는 Ollama보다 ExLlama 쪽이 실사용하기 편하다는 느낌입니다.
물론 단점도 있습니다. ExLlama는 아무 모델이나 그대로 사용할 수 있는 게 아니라 EXL3 같은 지원 포맷으로 변환된 모델을 사용해야 한다는 제약이 있으니까요.
그래도 RTX 5060 Ti 16GB라는 비교적 제한적인 VRAM에서도 27B급 모델을 이 정도로 안정적으로 굴릴 수 있다는 점은 꽤 재미있습니다.
아직 완벽하다고 할 정도는 아니지만,
"로컬 LLM을 테스트해보는 단계"에서 "실제로 업무에 써볼 수 있는 단계"로 한 단계 올라온 느낌입니다.
당분간은 Ollama와 ExLlama를 번갈아 사용하면서 실제 작업 기준으로 차이를 좀 더 봐야겠네요. 😄