Postingan ini belum diterjemahkan ke Bahasa Indonesia. Menampilkan teks asli.
프롬프트는 "가을 단풍을 소재로 컴퓨터의 슈퍼스칼라 아키텍처를 설명해주세요" 줬구요.
결과는
가을 단풍나무를 하나의 CPU라고 생각해 보자.

나무 전체 = 프로세서
가지 = 실행 유닛(ALU, FPU, load/store 등)
단풍잎 = 명령어
바람 = 클럭(사이클)
잎을 받는 바구니/수집망 = 결과 저장, 재정렬 버퍼 등
스칼라(scalar) 아키텍처는 바람이 한 번 불 때 단풍잎이 한 장만 떨어지는 구조다. 즉 한 사이클에 명령어 하나를 발행·실행한다.

슈퍼스칼라(superscalar) 아키텍처는 한 번의 바람(1 사이클)에 여러 단풍잎이 동시에 떨어질 수 있도록 나무에 여러 가지와 수집망을 둔 구조다. CPU가 한 사이클에 여러 명령어를 fetch/decode/issue하고, 여러 실행 유닛에서 동시에 실행할 수 있다. 예를 들어 2-way 슈퍼스칼라는 한 사이클에 최대 2개, 4-way는 최대 4개의 명령어를 발행할 수 있다.

하지만 단풍잎이 아무리 많아도 모두 동시에 떨어지는 것은 아니다. 잎 사이에 줄이 연결되어 있으면—즉 데이터 의존성이나 제어 의존성이 있으면—먼저 떨어진 잎의 결과가 있어야 다음 잎이 떨어질 수 있다. 그래서 슈퍼스칼라는 서로 독립적인 잎, 즉 명령어 수준 병렬성(ILP)이 있는 명령어들을 골라 동시에 떨어뜨린다.

또한 실제로는 프로그램 순서와 실행 순서가 다를 수 있다. 나무에 매달린 순서는 프로그램 순서지만, 실제로는 “준비된 잎부터” 떨어질 수 있다. 이것이 비순차 실행(out-of-order execution)이다. 최종 결과는 프로그램 순서대로 정리해야 하므로 재정렬 버퍼(reorder buffer) 같은 바구니가 필요하다. 같은 이름의 잎(레지스터)을 서로 다른 바구니로 이름을 바꾸는 레지스터 리네이밍은 불필요한 의존성 줄을 끊어 더 많은 잎이 동시에 떨어지게 한다. 분기 예측은 “이 가지에서 잎이 떨어질까?”를 미리 예측해 잎을 미리 떨어뜨리는 투기적 실행(speculation)이고, 예측이 틀리면 그 잎은 버린다.

정리하면, 가을 단풍 장면에서 한 바람에 여러 단풍잎이 동시에 떨어지는 것이 슈퍼스칼라의 핵심이고, 잎 사이의 줄(의존성), 가지 수(실행 유닛), 바구니(재정렬), 바람 예측(분기 예측)이 실제 성능을 결정한다. 슈퍼스칼라는 하드웨어가 동적으로 어떤 잎을 함께 떨어뜨릴지 결정하는 방식이고, VLIW는 컴파일러가 미리 여러 잎을 묶어 놓는 방식이라고 대비할 수 있다.
나름 열심히 정리는 해준 것 같습니다.
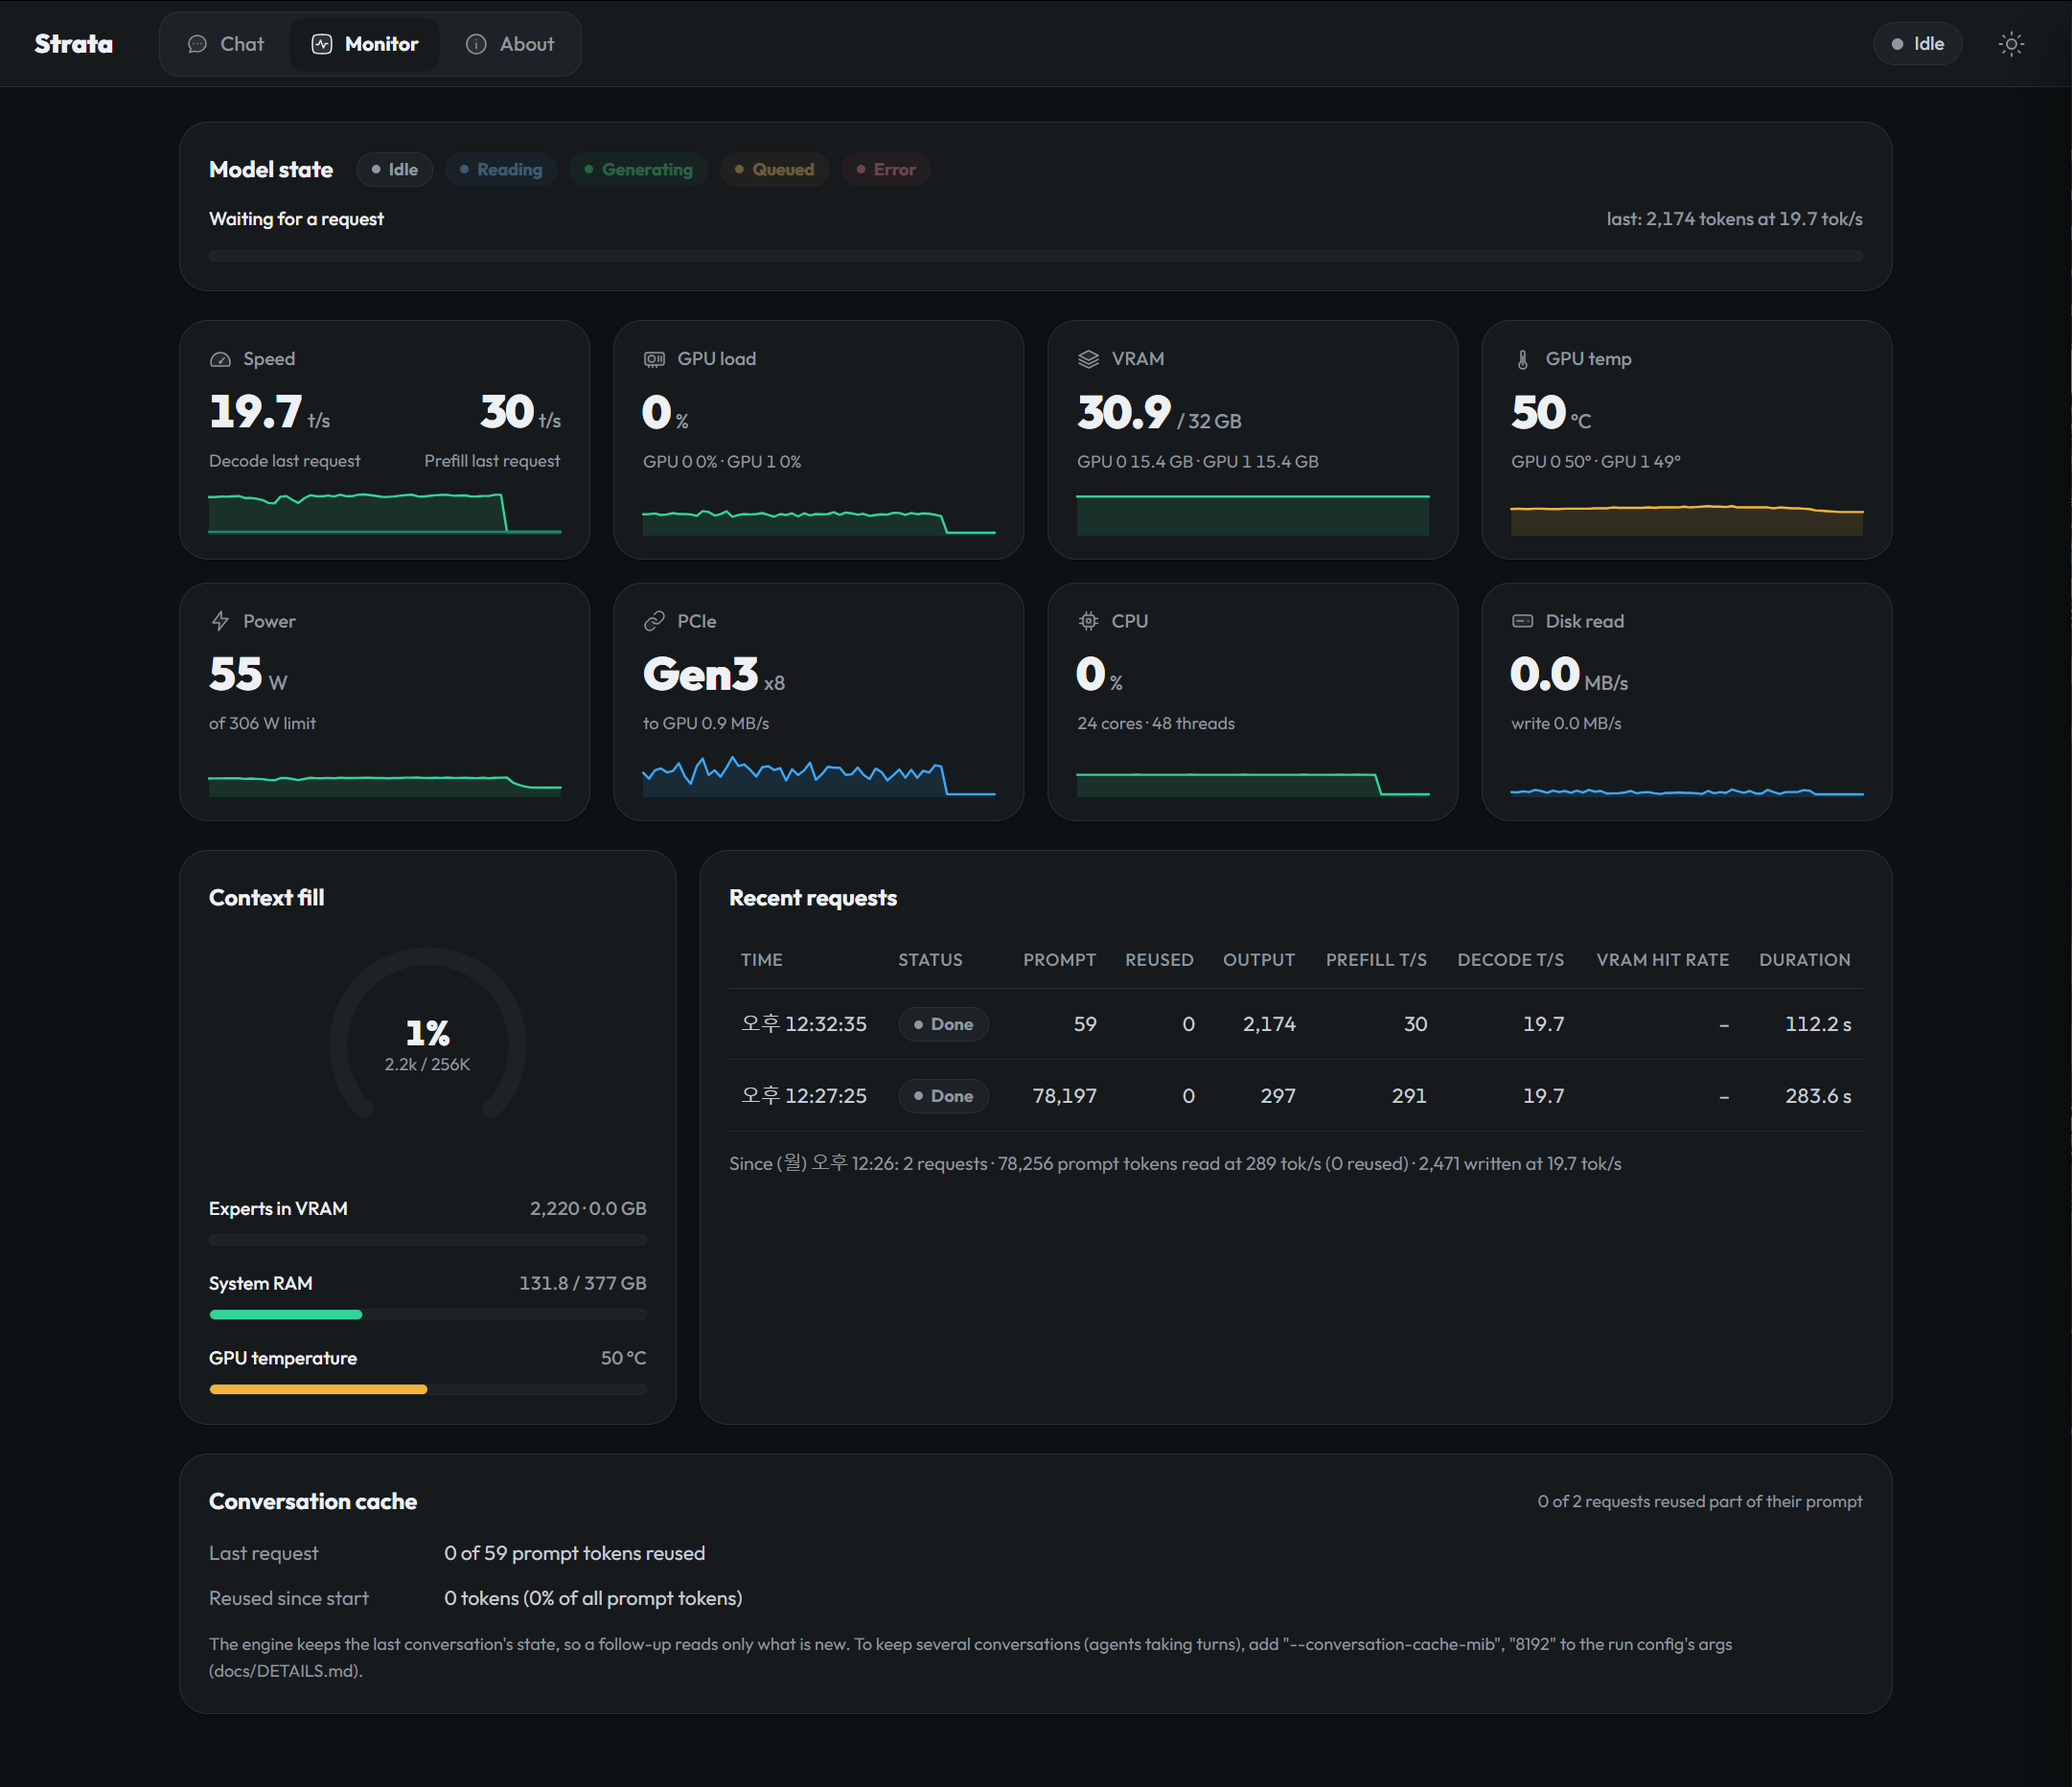
속도는 10 t/s 정도 나오지 않을까 했는데, 생각보다는 빠른 19 t/s 나왔습니다.
덩치가 커서 다운로드건 실제 사용이건 인내심이 필요한 것 같습니다.
그래도 리뷰용으로는 쓸 수 있을 것 같다는 생각이 듭니다.
참고로 제 환경은 6262V + 5060ti x 2 입니다.