Postingan ini belum diterjemahkan ke Bahasa Indonesia. Menampilkan teks asli.
llm wiki는 vllm + swift 1.5 기반으로 확정하고, 설정 최적값을 좀 찾아보고 있습니다.
MTP는 기존 3보다 4가 더 나은 결과를 보여줘서 쉽게 찾은 것 같구요.
chatgpt가 max-num-batched-tokens 을 4096에서 8192로 바꿔보라고해서 해보다가...
OOM에 계속 줘 터지고 있습니다.
max-model-len 131072
gpu_memory_utilization 0.925
max-num-batched-tokens 6144
로 터지지는 않고 테스트 돌고 있는데...
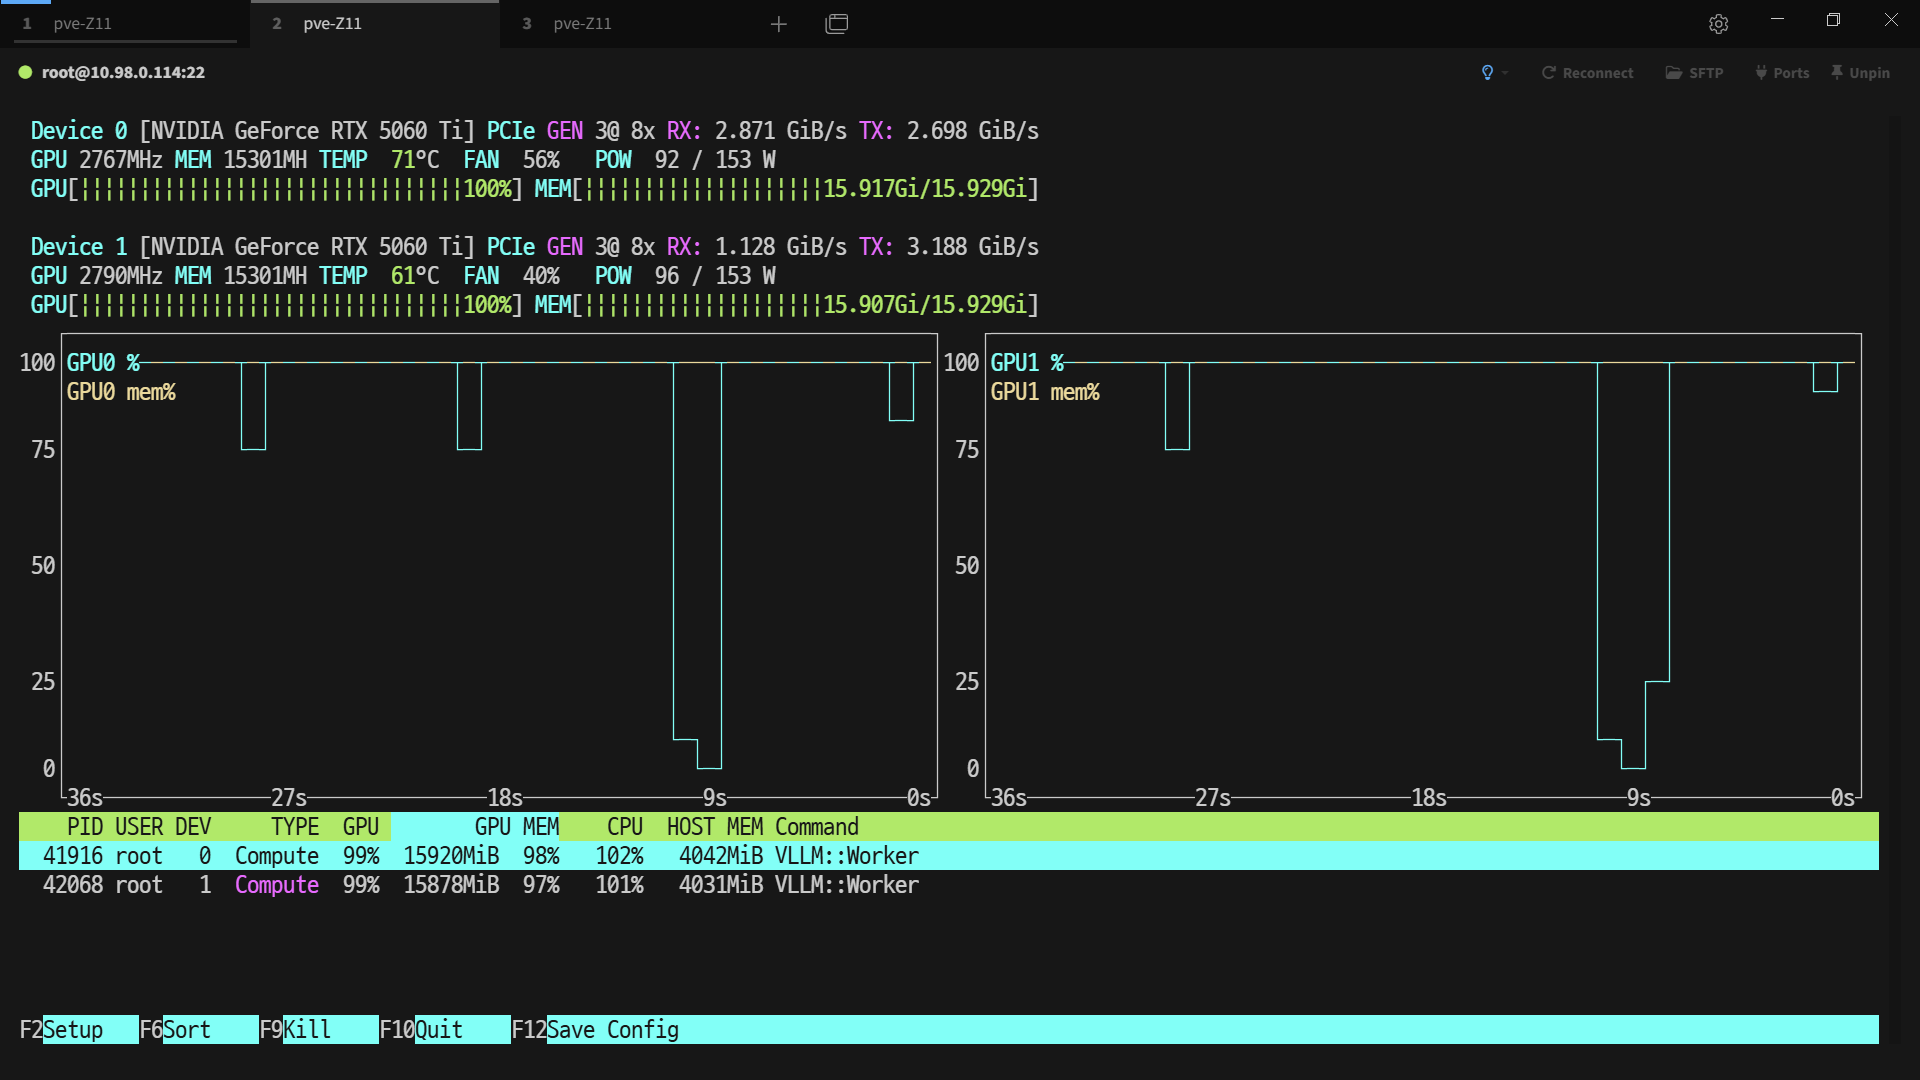
nvtop으로 보면 간당간당 합니다.
안터지기를 ㅠ.ㅠ